

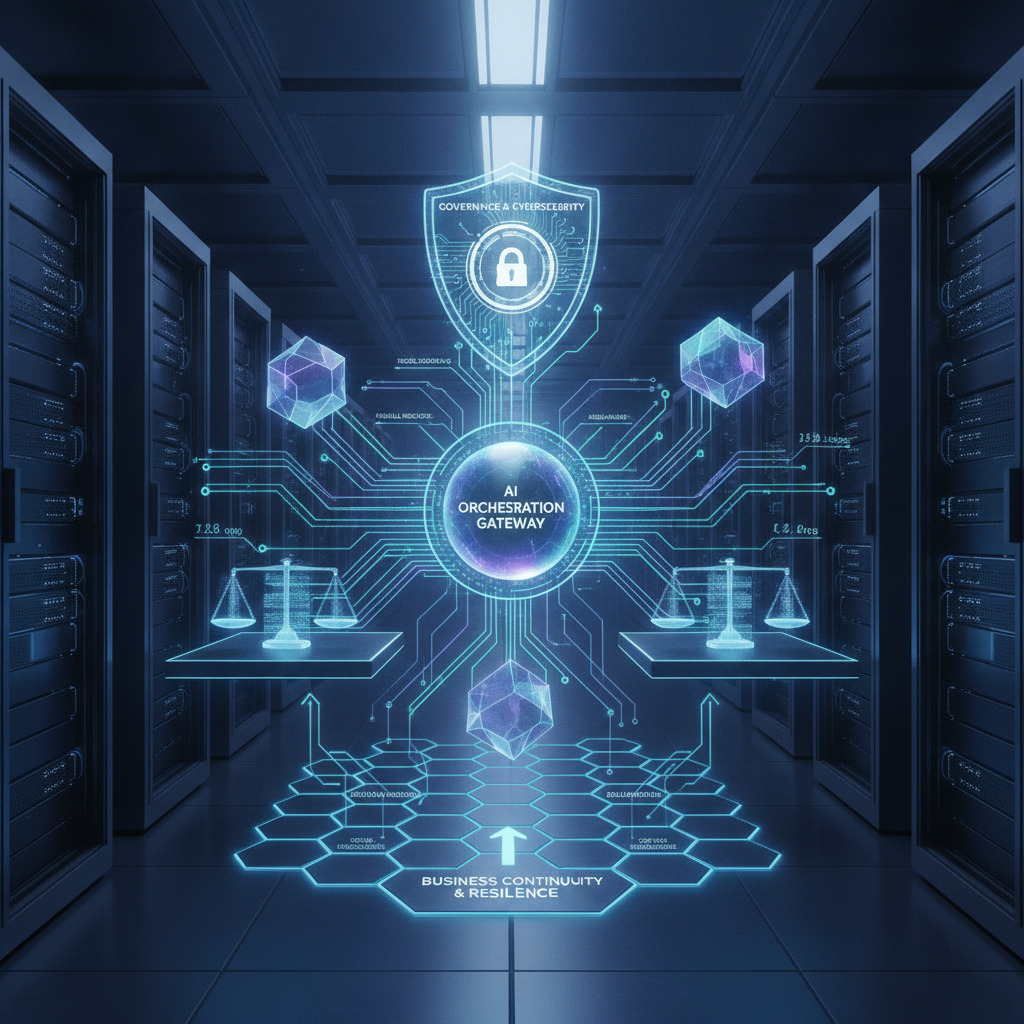
Combinar diferentes modelos de IA, dividir tarefas e reaproveitar resultados deixou de ser truque de produtividade individual e passou a ser decisão de arquitetura corporativa. Entenda os impactos em custo, governança, segurança e continuidade.
Introdução contextual
A adoção corporativa de inteligência artificial entrou em uma fase em que a pergunta relevante já não é se a empresa deve usar modelos generativos, mas como deve combiná-los. Durante os primeiros ciclos de experimentação, predominou uma lógica de ferramenta única: escolhia-se um fornecedor, concentravam-se ali todos os casos de uso e media-se o retorno pela velocidade com que as equipes passaram a produzir textos, códigos e análises. Esse modelo simples, porém, começa a mostrar limites econômicos e operacionais.
O custo por token, a latência, a qualidade em domínios específicos e a exposição de dados sensíveis variam de forma significativa entre modelos. Tratar todos os problemas com o mesmo motor é o equivalente a usar um caminhão de carga para entregas de bicicleta: funciona, mas desperdiça recurso. A discussão sobre orquestração de modelos — dividir tarefas entre diferentes IAs, reaproveitar resultados e desenhar fluxos eficientes — ganhou tração justamente porque traduz um problema técnico em uma decisão de arquitetura e de gestão de custos.
O que aconteceu
Publicações especializadas em tecnologia passaram a orientar usuários e equipes a combinar ferramentas de IA em vez de depender de um único assistente. A proposta é direta: distribuir tarefas conforme a especialidade de cada modelo, reutilizar saídas já geradas para evitar reprocessamento e construir fluxos em que modelos menores e mais baratos executem etapas simples, reservando os modelos mais caros e capazes para raciocínio complexo, análise de contexto extenso ou geração de maior qualidade.
Na prática, isso significa adotar padrões como:
- Roteamento por tarefa: classificar a demanda antes de escolher o modelo, em vez de enviar tudo ao mesmo endpoint.
- Cache e reaproveitamento: armazenar respostas e artefatos intermediários para não pagar novamente por cálculos idênticos.
- Pipeline em etapas: usar um modelo para extração, outro para sumarização e um terceiro para revisão crítica.
- Fallback controlado: definir modelos alternativos para quando o principal falhar, degradar ou ficar indisponível.
O movimento dialoga com a consolidação de camadas de abstração — gateways de IA, frameworks de orquestração e plataformas de avaliação — que permitem trocar modelos sem reescrever aplicações. A notícia original, publicada pelo TechTudo, reforça que a economia de tokens deixou de ser detalhe contábil e passou a orientar escolhas técnicas.
Por que isso importa para empresas
Em ambientes corporativos, o consumo de tokens escala com o número de usuários, integrações e automações. O que começa como um piloto de baixo custo pode se transformar rapidamente em uma linha de despesa relevante quando centenas de colaboradores passam a usar assistentes embutidos em sistemas internos. A orquestração ataca esse problema em três frentes.
1. Eficiência econômica
Modelos de fronteira cobram proporcionalmente ao volume processado. Se 70% das consultas são perguntas simples — classificação, extração de campos, respostas padronizadas —, executá-las em modelos menores reduz custo marginal sem perda perceptível de qualidade. O ganho não vem de negociar preço, mas de desenhar o fluxo correto.
2. Qualidade e especialização
Nenhum modelo lidera todas as categorias simultaneamente. Alguns se destacam em código, outros em análise de documentos longos, outros em idiomas específicos. Combinar ferramentas permite escolher o melhor motor para cada etapa, elevando a confiabilidade do resultado final.
3. Resiliência operacional
Depender de um único provedor cria um ponto único de falha. Indisponibilidade, mudança de política de uso, alteração de preço ou descontinuação de versão podem interromper processos críticos. Uma camada de orquestração com fallback reduz esse risco e aumenta a continuidade.
Impacto para cibersegurança, governança, IA e continuidade
A combinação de múltiplos modelos amplia a superfície de exposição. Cada integração adicional é um novo caminho por onde dados podem transitar, e cada fornecedor traz seu próprio regime de retenção, treinamento e localização de dados. Sem política clara, a orquestração pode multiplicar riscos de vazamento e de uso indevido de informação sensível.
Do ponto de vista de governança, surgem exigências novas:
- Inventário de modelos: saber quais modelos estão em uso, para quais finalidades e sob quais contratos.
- Classificação de dados: definir o que pode ser enviado a modelos externos e o que deve permanecer em ambiente controlado.
- Rastreabilidade: registrar qual modelo gerou cada saída, com qual prompt e em que contexto, para auditoria e resposta a incidentes.
- Avaliação contínua: medir qualidade, viés e aderência regulatória antes de promover um modelo a produção.
Em continuidade de negócios, a orquestração funciona como redundância planejada. Um gateway que abstrai provedores permite migrar tráfego em caso de incidente, mantendo serviços analíticos e assistivos ativos. O custo dessa arquitetura é menor do que o de uma paralisação causada por dependência exclusiva.
A pergunta estratégica deixou de ser “qual é o melhor modelo?” e passou a ser “qual é a melhor combinação de modelos para cada processo, com custo, risco e qualidade aceitáveis?”
Leitura executiva da WSVP
Na avaliação da WSVP, a orquestração de IAs deve ser tratada como decisão de arquitetura corporativa, não como tática de produtividade individual. Empresas que padronizam um único fornecedor tendem a acumular custo crescente e dependência tecnológica; as que combinam modelos sem governança criam dispersão, risco de segurança e dificuldade de auditar resultados.
O caminho equilibrado passa por uma camada de abstração central — um gateway interno que padroniza autenticação, políticas de dados, métricas de custo e roteamento — sobre a qual os times constroem casos de uso. Essa camada permite trocar modelos sem reescrever aplicações, aplicar políticas uniformes de segurança e comparar desempenho com base em evidências, não em preferências.
Do ponto de vista de retorno, a orquestração tende a produzir ganhos em duas ondas. A primeira é imediata e mensurável: redução de custo por tarefa ao direcionar demandas simples para modelos econômicos. A segunda é estrutural: maior capacidade de incorporar inovações sem reengenharia, o que encurta o ciclo entre lançamento de um novo modelo e sua adoção produtiva.
A WSVP recomenda ainda que a discussão seja conduzida conjuntamente por tecnologia, segurança, jurídico e áreas de negócio. Sem essa articulação, decisões de custo podem conflitar com exigências regulatórias, e ganhos de eficiência podem ser anulados por incidentes de conformidade.
Recomendações práticas
- Mapeie tarefas antes de escolher modelos. Classifique os casos de uso por complexidade, sensibilidade de dados e frequência. Só então defina qual motor atende cada faixa.
- Implante uma camada de orquestração. Centralize autenticação, roteamento, cache e registro de chamadas. Isso reduz retrabalho e facilita auditoria.
- Estabeleça política de dados por classe. Determine o que pode sair do perímetro e o que exige modelos hospedados em ambiente controlado.
- Meça custo por resultado, não apenas por token. Métricas como custo por documento processado, por atendimento resolvido ou por análise concluída orientam melhor a decisão.
- Crie testes de avaliação contínuos. Compare modelos periodicamente em tarefas reais e mantenha critérios objetivos de promoção e substituição.
- Planeje fallback e continuidade. Defina modelos alternativos, limites de degradação aceitável e procedimentos de contingência.
- Documente e treine. Equipes precisam saber quando usar cada ferramenta e como registrar decisões relevantes para rastreabilidade.
Fontes consultadas
- TechTudo — Ainda usa só uma IA? Aprenda a combinar ferramentas e economizar tokens
- NIST — AI Risk Management Framework
- OWASP — Top 10 for Large Language Model Applications
- Google Cloud — Architecture Center: AI/ML
Disclaimer
Este rascunho foi produzido com apoio de inteligência artificial e ainda requer revisão humana antes da publicação.